
Платформа для интеллектуального извлечения данных из документов
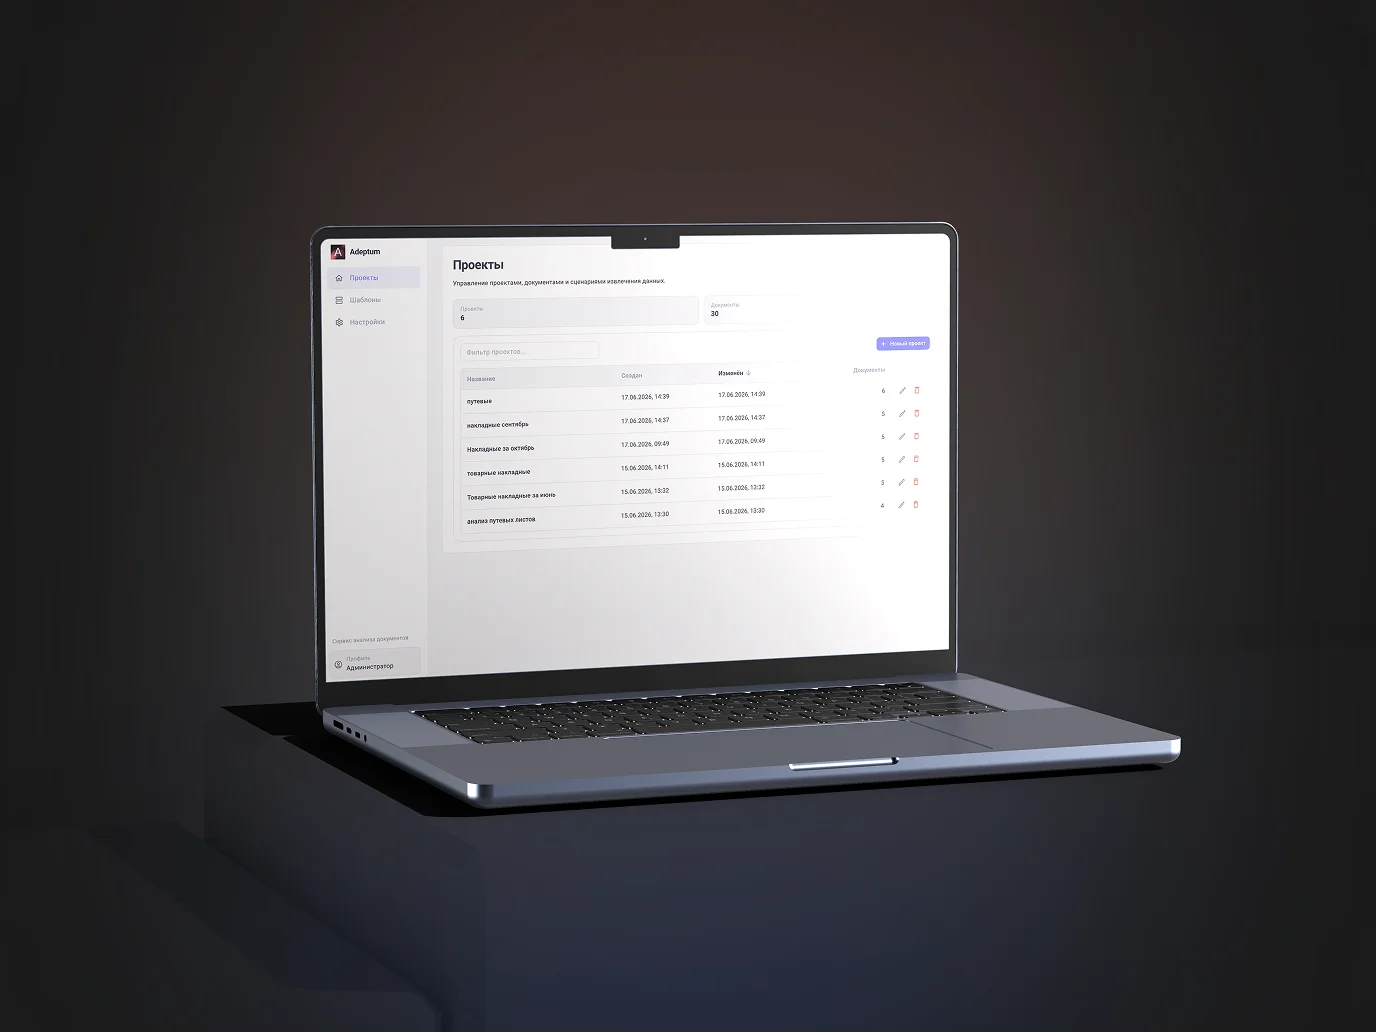
задача
Компании получают документы в разных форматах: PDF, сканы, Word, Excel, XML ЭДО. Вручную извлекать из них реквизиты, суммы, таблицы, ИНН, даты и другие поля долго, дорого и рискованно из-за ошибок
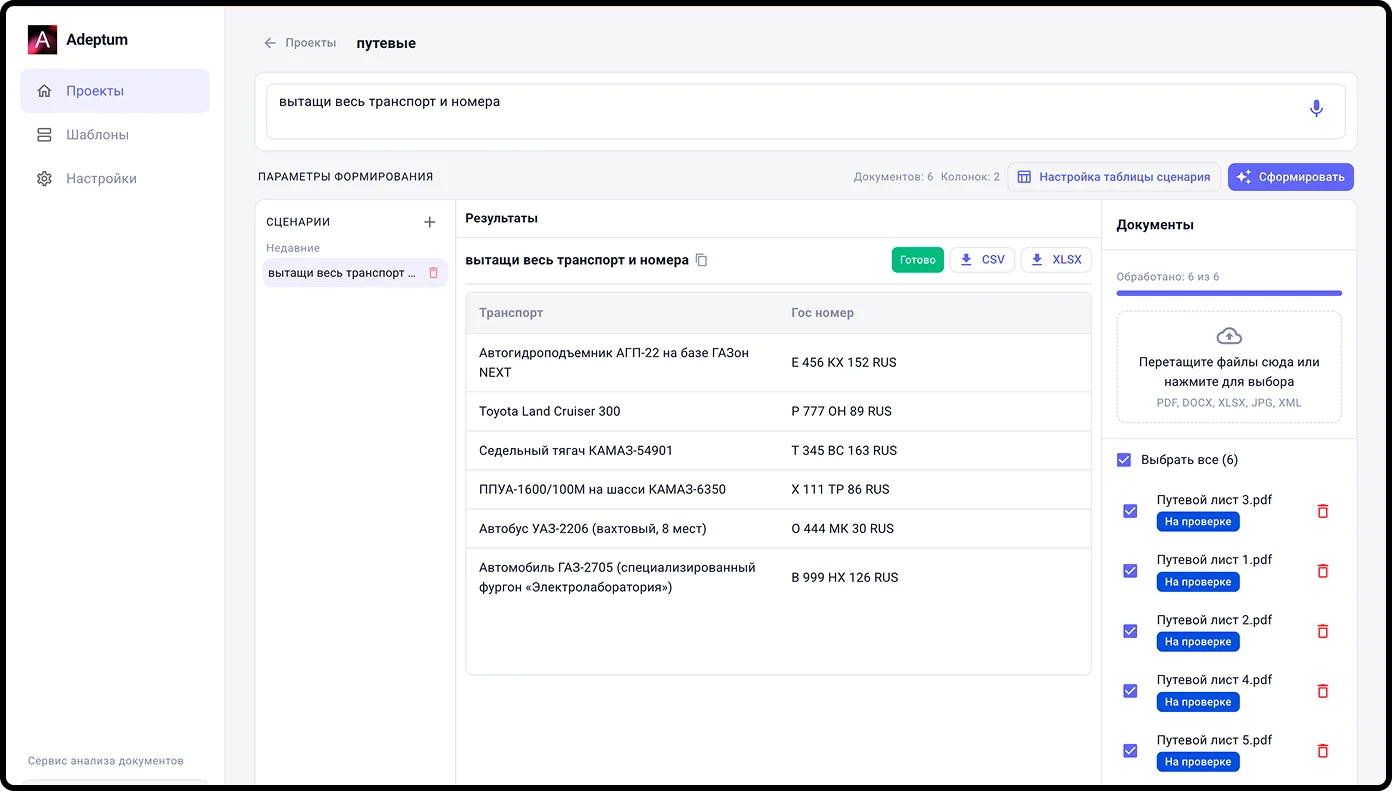
решение
Мы разработали универсальный продукт для сбора и структурирования информации из загруженных документов: пользователь задает вопрос на обычном языке, а система сама достает и валидирует нужную информацию в агрегированном виде Решение не привязано к одному типу документа. Его можно адаптировать под договоры, счета, накладные, резюме, тендерную документацию и другие форматы
01
Поддержка всех популярных форматов файлов
02
Обработка сканов и изображений с использованием компьютерного зрения
03
Возможность использования локальных ИИ
04
Автоматическая эскалация обработки при низком качестве извлеченного текста
05
LLM-нормализация под пользовательскую схему
06
Настраиваемые шаблоны данных
07
Изменения статуса обработки документов в реальном времени
08
Возможность ручной корректировки значений

результат
Система ускоряет обработку неструктурированных документов и снижает ручную нагрузку на сотрудников. Пользователь получает структурированную таблицу данных с указанием источника и уровня уверенности Операционные метрики:
01
Точность обработки по документу и полю
02
Длительность стадий парсинга
03
Количество обработанных документов
04
Фильтр значений с низкой уверенностью
Для кого

